Durante años, el problema del JavaScript en SEO era cuestión de Google: si Googlebot no veía tu contenido, no te indexaba. Hoy hay una pregunta más: ¿lo ven también los rastreadores de la IA? Y aquí la respuesta cambia bastante.
Ya expliqué en cómo rastrear e indexar páginas con JavaScript cómo renderiza Google. En este post vamos un paso más allá: qué diferencia hay entre renderizar en el cliente o en el servidor, qué bots ejecutan JavaScript y cuáles no, y cómo comprobarlo en tu web.
CSR y SSR: quién construye el HTML
- CSR (Client Side Rendering): el servidor envía un HTML casi vacío (un
<div id="app"></div>y unos scripts) y es el navegador, o el rastreador, quien ejecuta el JavaScript para pintar el contenido. - SSR (Server Side Rendering): el servidor ejecuta el JavaScript, genera el HTML completo y lo envía ya montado. El navegador o el bot recibe el contenido en la primera respuesta.
Hay variantes que cumplen el mismo objetivo: generación estática (SSG), que crea el HTML en el momento del despliegue, y el pre-renderizado, que sirve una versión ya renderizada (por ejemplo con Prerender.io) cuando no se puede hacer SSR. Lo importante en todos los casos es lo mismo: el contenido está en el HTML inicial. Ojo con una variante concreta, el dynamic rendering (servir HTML prerenderizado solo a los bots y la versión normal a los usuarios): la guía de Sitebulb lo da por obsoleto y recuerda que Google recomienda SSR, generación estática o hidratación.
| CSR | SSR | |
|---|---|---|
| Quién renderiza | El navegador o el bot | El servidor |
| Contenido en el HTML inicial | No (o muy poco) | Sí |
| Depende de que el bot ejecute JS | Sí | No |
| Carga del servidor | Baja | Mayor (hay que generar cada petición) |
| Riesgo SEO | Alto: lo que no se renderiza no existe | Bajo: todos reciben la misma versión |
| Frameworks habituales | React, Vue o Angular sin configuración extra | Next.js, Nuxt, Angular Universal / SSR, SvelteKit, Astro |
El SSR tiene un coste: más trabajo para el servidor en cada URL. A cambio, te quitas de encima la duda de si el bot ejecutará o no tu código. Y esa duda hoy es más relevante que nunca.
Quién ejecuta JavaScript y quién no
Googlebot lleva años renderizando páginas con una versión actualizada de Chromium (lo que llamaron evergreen), aunque lo hace en una segunda fase, tras rastrear el HTML. Con los rastreadores de IA la situación es distinta.
El estudio más citado es el de Vercel y Merj, que analizó el tráfico real de varios rastreadores en sus redes. Sus conclusiones: GPTBot (OpenAI) y ClaudeBot (Anthropic) llegan a descargar archivos JavaScript (en torno al 11,5 % y al 23,8 % de sus peticiones, respectivamente), pero no los ejecutan. Entre los más de 500 millones de peticiones de GPTBot analizadas no encontraron ni una prueba de ejecución de JS.
Con esa base y lo que se conoce del resto, este es el cuadro:
| Rastreador | ¿Ejecuta JavaScript? | Notas |
|---|---|---|
| Googlebot | Sí | Renderiza con Chromium actualizado, en una segunda fase tras el rastreo del HTML |
| Gemini / Modo IA de Google | Sí (vía Googlebot) | Según el estudio de Vercel y Merj, Gemini aprovecha la infraestructura de renderizado de Google |
| Applebot | Sí | También lo recoge el estudio de Vercel y Merj |
| Bingbot | Sí, con límites | Renderiza, aunque con menos margen que Google: no conviene apostar todo a ello |
| GPTBot (OpenAI) | No | Descarga JS pero no lo ejecuta |
| OAI-SearchBot y ChatGPT-User | No documentado | OpenAI no lo detalla; asumo que no, a la espera de pruebas |
| ClaudeBot (Anthropic) | No | Descarga JS pero no lo ejecuta |
| PerplexityBot | No | Según el estudio de Vercel y Merj |
| Meta-ExternalAgent y Bytespider | No | Según el mismo estudio |
| Rastreadores sociales (facebookexternalhit, LinkedInbot, Twitterbot…) | No | Leen el HTML inicial para las vistas previas al compartir |
Dos advertencias importantes. La primera: estos datos cambian. Los proveedores de IA no suelen documentar con precisión qué hace cada bot, así que esta tabla es una foto de hoy y conviene revisarla de vez en cuando. La segunda: los bots de IA no se comportan como un único rastreador. Distinguir entre el que entrena modelos, el que alimenta el buscador y el que lee una URL cuando un usuario lo pide es parte de lo que conté en segmentar el bloqueo de bots y en qué leen los bots de la IA.
Qué significa esto en la práctica
Si tu contenido depende de JavaScript:
- Google lo verá, aunque tarde más en renderizarlo y con riesgo de fallos si algo no carga.
- La mayoría de rastreadores de IA solo verán el HTML vacío. Tu marca, tus productos o tus artículos no llegarán a ChatGPT, Claude o Perplexity, o llegarán incompletos.
- Las vistas previas al compartir en redes (título, imagen, descripción) pueden salir mal si las etiquetas se inyectan por JS.
Es decir, tu web puede estar perfectamente indexada en Google y ser invisible para buena parte de la IA. Si te preocupa aparecer en las respuestas de IA, este es el primer filtro técnico.
Por qué SSR (o equivalente) es la opción segura
El objetivo es que todos reciban la misma versión del contenido, sin depender de las capacidades de cada bot. Con SSR:
- El contenido principal, los enlaces internos (también los de una paginación), los títulos, la meta description, el canonical y los datos estructurados están en el HTML inicial.
- No hay que esperar a la cola de renderizado de Google.
- Los bots de IA, los rastreadores sociales y cualquier herramienta sencilla leen lo mismo que Googlebot.
Si no puedes migrar a SSR, prioriza el pre-renderizado o la generación estática para las páginas que más importan. Y si hay partes que sí pueden cargarse por JS (un widget de comentarios, un carrusel), que sean contenido secundario, no el que quieres posicionar.
En un ecommerce no hace falta renderizarlo todo en servidor
Según la guía de Sitebulb, la pregunta no es “¿CSR o SSR?” sino qué partes necesitan tener el contenido antes de ejecutar JavaScript. Para las páginas con intención orgánica (home, categorías, productos), el contenido, los enlaces internos y los metadatos deben llegar en el HTML inicial. El JavaScript puede encargarse de filtros, personalización y animaciones. Para lo que no queremos posicionar (checkout, cuenta de usuario, listas de deseos), CSR es perfectamente válido. Es un enfoque híbrido.
Como dato, la guía cita el caso de StreetStyle24: tras mover el contenido crítico al HTML base, el número de palabras clave posicionadas en el top 3 subió un 28 %. Es un caso aislado, así que tómalo como ejemplo y no como promesa.
Cómo validarlo con Search Console
La herramienta Inspección de URLs de Google Search Console te dice cómo ve Google una página concreta. Con la prueba en vivo puedes comprobar que se renderiza bien:
- En Search Console, escribe la URL en el cuadro de búsqueda superior (Inspeccionar cualquier URL de…).
- Pulsa Probar URL publicada para que Google solicite la página en ese momento (no la versión guardada en el índice).
- Cuando termine, pulsa Ver página probada.
- Revisa las pestañas:
- HTML: el código renderizado que ha obtenido Google. Busca en él tu contenido principal, los enlaces internos, el título y los datos estructurados.
- Captura de pantalla: cómo se ve la página. Solo está disponible en la prueba en vivo.
- Más información: los recursos cargados (aquí verás si algún JS o CSS está bloqueado), los mensajes de la consola de JavaScript y el código de respuesta HTTP.
- Si algo falta, mira en Más información si hay recursos que no se han podido cargar o errores de JavaScript.
Para una página ya indexada, también puedes usar Ver página rastreada y ver el HTML que Google tiene guardado.
Un matiz que conviene tener claro
El HTML que muestra Search Console es el renderizado, no el original. Si tu contenido aparece ahí, demuestra que Google es capaz de ejecutar tu JavaScript, pero no demuestra que uses SSR. Una web en CSR puede salir perfecta en Search Console y ser invisible para GPTBot o ClaudeBot.
Por eso la validación tiene dos pasos: ver qué ve Google (Search Console) y ver qué hay en el HTML antes de ejecutar nada.
Cómo comprobar el HTML sin renderizar
Estas tres pruebas te dicen si el contenido llega en la primera respuesta del servidor:
- Ver código fuente: en Chrome,
Ctrl + U(oview-source:antes de la URL). Es el HTML original, sin JavaScript ejecutado. Busca conCtrl + Funa frase de tu contenido. Si no está, tienes CSR. - Desactivar JavaScript: en las herramientas de desarrollo de Chrome (
F12),Ctrl + Shift + P, escribe Disable JavaScript y recarga. Lo que ves es, más o menos, lo que ve un bot que no renderiza. - Descargar el HTML con un user agent de IA: te dice si el servidor responde igual a estos bots (un firewall o un CDN pueden bloquearlos o servirles otra cosa).
curl -s -A "GPTBot" https://tudominio.com/pagina | grep -i "frase de tu contenido"
Si la frase aparece, el contenido está en el HTML. Si no, ese bot no lo está viendo. Puedes repetirlo cambiando el user agent por ClaudeBot o PerplexityBot. Si quieres replicar el entorno con más detalle, tienes la guía de cómo auditar tu sitio emulando a Googlebot, y también puedes hacerlo en bloque con un rastreador como Screaming Frog configurando el renderizado en “Solo texto” y comparándolo con “JavaScript”.
Automatiza la comprobación antes de publicar
Estas pruebas valen más si se ejecutan antes de que el cambio llegue a producción. En una charla sobre tiendas Shopify, Estela Franco propone automatizar esos controles en el proceso de despliegue (CI): un rastreo simulando a Googlebot móvil (con su user agent y un viewport de 412x732) sobre el entorno de staging, que valida cada plantilla (home, producto, colección) contra un “contrato SEO” en JSON, con severidad de advertencia o bloqueante. Detecta, entre otros, canonicals y meta robots rotos, títulos y descripciones ausentes, datos estructurados defectuosos, contenido que no se renderiza y enlaces que solo existen en JavaScript. Su argumento es que la mayoría del testing SEO ocurre aún en producción, con más de 30 días para recuperar posiciones. Si tu equipo despliega a menudo, merece la pena preguntarse cuántos de esos fallos podrían haberse parado antes.
Conclusiones
- Google renderiza JavaScript. La mayoría de rastreadores de IA, hoy, no.
- CSR deja la decisión de ver tu contenido en manos de cada bot. SSR (o pre-renderizado, o generación estática) pone el contenido en el HTML inicial y asegura que todos ven lo mismo.
- Search Console te confirma lo que ve Google, pero no si usas SSR: para eso hay que mirar el código fuente sin renderizar o simular un bot de IA con
curl. - Revisa estas pruebas tras cualquier migración o cambio de framework. Es de esos errores que no dan la cara en Search Console y te cuestan visibilidad en la IA sin que te enteres.
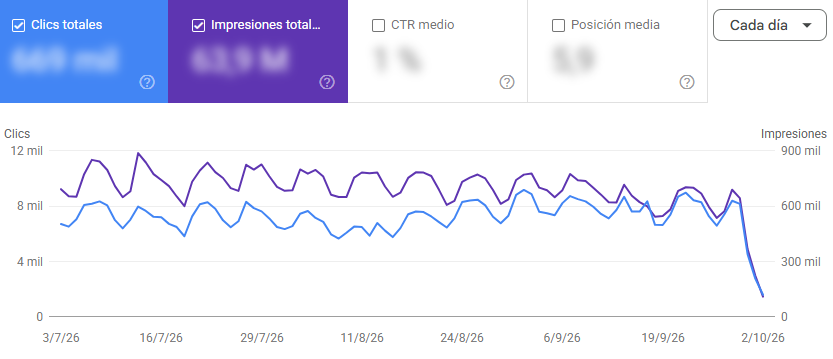
- Y revisa tus datos cada cierto tiempo. Un cambio técnico puede romper el rastreo o el renderizado sin que nadie lo note, y la única señal es una caída como esta en Search Console. Mejor verla en una semana que en un mes:
Si tu web está en CSR y todavía no sabes qué ven los bots de IA, esta es la prueba más rápida que puedes hacer hoy: abre el código fuente y busca tu contenido.
Este artículo forma parte de la guía SEO técnico en la era de la inteligencia artificial.
Este artículo forma parte de la guía El SEO en la era de la IA - Cómo optimizar para los modelos de lenguaje.