Cuando reviso listados de bloqueo de bots como el de The Ultimate Bad Bot Blocker, de Mitchell Krogza, me encuentro siempre con la misma inquietud: ese archivo aplica un criterio de bloqueo indiscriminado. En la misma lista mete herramientas de hacking —sqlmap, Nikto— junto a plataformas legítimas de auditoría SEO, redes sociales, monitorización o inteligencia artificial. Bloquear así, sin segmentar, os puede salir más caro que dejar pasar tráfico de más.
Os dejo la segmentación que aplico para decidir qué vale la pena cortar, qué conviene desbloquear y qué solo hay que vigilar.
1. Bots de IA y scrapers de entrenamiento: bloquéalos sin miedo al SEO
Recolectan datos para entrenar modelos o alimentar búsquedas generativas. Bloquearlos no afecta a la indexación en Google ni en Bing, pero sí evita consumo de ancho de banda y el uso no remunerado de vuestro contenido.
- GPTBot / ChatGPT-User / openai.com (OpenAI)
- ClaudeBot / anthropic-ai (Anthropic)
- Bytespider / CCBot (Common Crawl / Bytedance —de los más agresivos en volumen de peticiones)
- cohere-ai / diffbot / ImagesiftBot
Si no tenéis una estrategia activa de GEO que necesite que os citen en respuestas de IA, podéis mantener esta categoría bloqueada sin ningún riesgo para el SEO tradicional.
Ojo, que ClaudeBot es el rastreador que entrena el modelo offline, distinto de WebFetch, la herramienta que Claude usa en tiempo real cuando alguien le pide que lea una URL durante una conversación. Sobre cómo ha cambiado ese segundo mecanismo, tienes más detalle en Claude ya no lee tu web directamente, primero la resume un modelo pequeño.
2. Herramientas SEO: ¿desbloquear o dejar fuera?
Rastrean la web para construir bases de datos de backlinks, keywords o auditorías. No afectan a las búsquedas de los usuarios finales; bloquearlas solo impide que herramientas externas —o la competencia— os analicen.
Desbloquéalas si las usáis internamente:
- Screaming Frog SEO Spider: imprescindible si vuestro equipo técnico hace auditorías del sitio.
- Siteimprove / OnCrawl / Botify / DeepCrawl: si pagáis suscripciones de accesibilidad o SEO corporativo que dependan de ellas.
Evalúalas caso por caso:
AhrefsBot, SemrushBot, MJ12bot (Majestic), Dotbot (Moz), SISTRIX, SearchmetricsBot, Serpstatbot, Cocolyzebot, SeobilityBot. Generan un volumen de peticiones alto. Si no usáis esas plataformas para analizar vuestro propio sitio y no os importa que la competencia vea vuestros datos de backlinks, dejadlas bloqueadas y ahorráis recursos de servidor.
3. Infraestructura, redes sociales y utilidades: aquí es donde más cuidado hay que tener
El listado original incluye agentes que prestan servicios legítimos, y bloquearlos en el CDN o en robots.txt genera fallos funcionales silenciosos —de esos que nadie detecta hasta que alguien se queja.
- FacebookBot / facebookscraper: si los bloqueáis, al compartir un enlace en Facebook, Instagram o WhatsApp no cargará la tarjeta OpenGraph (imagen, título, descripción).
- archive.org_bot: es la Wayback Machine, conserva el registro histórico de vuestro sitio.
- BuiltWith: solo identifica vuestra pila tecnológica, inofensivo.
- Monitores de uptime: bloquearlos os va a traer alertas falsas de que la web está caída.
- iubenda-radar: necesario si usáis Iubenda o un servicio similar de legaltech para verificar la política de cookies.
4. Scanners y bots maliciosos: aquí no hay debate
Acunetix, Nikto, Dirbuster, Nmap, Sqlmap, WPScan, Havij, Nessus, OpenVAS, Nuclei, ZmEu —escáneres de vulnerabilidades. EMail Siphon, EMail Wolf, Autoemailspider, CherryPicker —extractores masivos de email. HTTrack, WinHTTrack, Offline Explorer, WebZIP, SiteSucker —descarga masiva del sitio. Ninguno aporta valor comercial. Se quedan bloqueados a nivel de CDN o servidor, sin excepciones.
¿Qué impacto tiene todo esto en la indexación?
Cuando aplico un bloqueo en el CDN mediante robots.txt, lo primero que reviso es que los buscadores principales —Googlebot, Bingbot, YandexBot— no estén en la lista. Si no lo están, su capacidad de indexación no se ve alterada. Bloquear a sogouspider, por ejemplo, es correcto si no tenéis mercado objetivo en China.
Y si además metéis un rate limit en el buscador interno —5 peticiones por segundo por IP es un margen razonable—, el impacto en SEO es prácticamente nulo: Googlebot no suele interactuar ni indexar los resultados de búsquedas internas, y de hecho la buena práctica es bloquear la indexación de esas páginas de resultados (/search?q=) con noindex o desde robots.txt. Para un usuario humano navegando, 5 req/s es un margen holgado. Solo va a afectar a bots que intenten extraer el catálogo entero a través del buscador interno.
Cómo vigilar que todo se mantenga estable
- Google Search Console (Ajustes > Informe de estadísticas de rastreo): comprobar que no hay picos de errores 429 o 5xx desde que se aplicó el bloqueo.
- Logs del CDN o del WAF: revisar si hay IPs legítimas de usuarios —o de Googlebot— alcanzando el umbral de peticiones en alguna ruta compartida. Los mismos logs sirven para ver qué rastreadores de IA piden qué secciones, y cruzarlo con el informe de IA generativa y el valor de cada sección ayuda a decidir qué bloquear.
- Clarity como alternativa a los logs: si no tienes acceso a los logs del servidor, el dashboard Bot Activity de Microsoft Clarity (gratuito) muestra la actividad de bots en tu sitio. Desde septiembre de 2026 incluye Page Classification, que agrupa las URLs por tipo de página (producto, blog, contacto…) para ver, por ejemplo, si los bots se concentran en tu catálogo y no en el blog. Puedes crear tus propias categorías por ruta y tus reglas tienen prioridad sobre la clasificación automática, así que sirve para decidir con datos qué secciones merece la pena proteger.
- Los rastreadores de IA que sí quieres: si no ves ninguna petición de GPTBot, PerplexityBot o ClaudeBot, revisa robots.txt, el CDN, el firewall y la protección anti-bots, porque una regla pensada para bots abusivos puede estar bloqueándolos por error. Conviene mirar también las peticiones de bots de IA que acaban en 404, 499 o 5xx, que indican páginas que intentaron leer y no pudieron. Ojo con los bots que suplantan a uno real: en un caso que muestra Ahrefs, solo aparecían falsos ClaudeBot y ninguno auténtico. Para no fiarte solo del
User-Agent, verifica la IP con DNS inversa o con los rangos oficiales que publican Google, Bing, Apple u OpenAI. - Una prueba manual: compartir una URL interna en WhatsApp o Facebook para confirmar que la tarjeta OpenGraph sigue cargando y que los bots de previsualización no se han quedado atrapados en el bloqueo por error.
Y no os fiéis de mirarlo una vez y olvidarlo. Un bloqueo mal ajustado, una regla del firewall o un cambio en el CDN pueden hacer que el tráfico orgánico se hunda en cuestión de días, y si no revisáis vuestros datos cada cierto tiempo os enteraréis tarde. Así se veía en Search Console una caída de este tipo, sin que nadie hubiera avisado:
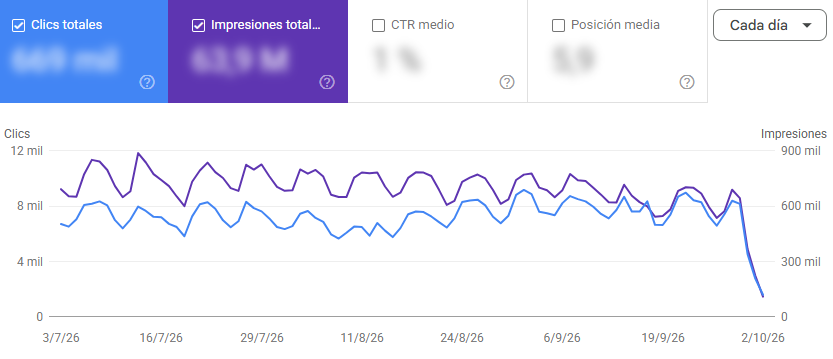
Revisar Search Console con una frecuencia fija (semanal, por ejemplo) y no solo cuando algo parece ir mal es lo que evita el susto. La caída ya habrá ocurrido, pero la detectáis en días y no en semanas.
Conclusiones
Bloquear bots no es un acto de todo o nada. Un archivo genérico de “bad bots” os ahorra el trabajo de pensar, pero os cuesta funcionalidad real: tarjetas que no cargan, alertas de caída falsas, herramientas de auditoría que dejan de responder. La única categoría que no admite debate es la de escáneres y descargadores masivos; todo lo demás depende de qué uséis y de qué os importe que vea la competencia. Segmentar cuesta una tarde. Arreglar un OpenGraph roto en producción, mucho más.
Este artículo forma parte de la guía SEO técnico en la era de la inteligencia artificial.