A día de hoy es fundamental priorizar la indexación de las páginas clave para asegurarnos de que nuestros contenidos de valor son indexados por los rastreadores.
Cuando hablamos de rastreo e indexación, es crucial entender y utilizar de forma correcta las herramientas que los buscadores ponen a nuestro alcance. Las dos más importantes son el fichero robots.txt y la directiva noindex. El error más habitual es creer que hacen lo mismo. No lo hacen, y combinarlas mal es una de las formas más fáciles de acabar con URLs indexadas que no querías en el índice.
Evitar el rastreo con el fichero robots.txt
El fichero robots.txt indica a los robots de los motores de búsqueda qué URLs de un sitio pueden o no rastrear. Los buscadores serios lo respetan, pero es un protocolo de cortesía, no un mecanismo de seguridad: cualquier rastreador puede ignorarlo. Y, sobre todo, solo afecta al rastreo, no a la indexación.
Este fichero debe estar siempre en la raíz del sitio y tener ese mismo nombre. Si disponemos de subdominios, cada uno de ellos necesita su propio fichero. En el caso de esta página, se ubica en:
https://emirodgar.com/robots.txt
En mi caso, he especificado que quiero bloquear el rastreo a una serie de robots de herramientas conocidas y también a los rastreadores de las inteligencias artificiales.
Para bloquear el rastreo hay que usar la directiva Disallow:
User-agent: *
Disallow: /privado/
Si queremos bloquear a un robot en concreto, sustituimos el User-agent: * por el nombre del rastreador, por ejemplo User-agent: Googlebot. La instrucción anterior evita que se rastree la carpeta /privado/ y todo lo que cuelga de ella. Si necesitas patrones más finos, tienes cómo usar expresiones regulares en el robots.txt.
Evitar la indexación con noindex
La directiva Disallow no garantiza que una página no aparezca en los buscadores. Para evitar que una URL se indexe hay que usar noindex, ya sea como metaetiqueta en el HTML:
<meta name="robots" content="noindex">
o como cabecera HTTP, que es la única opción para ficheros que no son HTML, como los PDF:
X-Robots-Tag: noindex
Dos matices que conviene tener presentes:
- Google dejó de soportar la directiva
noindexdentro del propiorobots.txten septiembre de 2019. Si ves una líneaNoindex:en un fichero, no hace nada. - Para que Google vea el
noindex, la página tiene que poder rastrearse. Es la clave de todo lo que sigue.
Cuidado al usar ambas directivas a la vez
Disallowbloquea el rastreo, pero no la indexación.noindexbloquea la indexación, pero necesita que la página se rastree para poder leerse.
Una URL bloqueada en robots.txt no se rastrea, así que Google no ve su contenido ni sus etiquetas. Pero si esa URL recibe enlaces, internos o externos, Google conoce su existencia y puede indexarla igualmente, sin contenido, a partir de la URL y del texto de los enlaces que apuntan a ella. De ahí que a veces veas resultados sin descripción o con el mensaje de que no hay información disponible por el robots.txt.
Un caso real, más de 9.000 URLs indexadas pese al bloqueo
Esto no es una rareza teórica. En un proyecto en el que trabajo, Search Console avisa de que 9,34 mil páginas están afectadas por el estado “Se ha indexado aunque un archivo robots.txt la tenía bloqueada”. Lo interesante es la evolución: prácticamente cero hasta finales de agosto de 2026 y una subida escalonada desde entonces, hasta estabilizarse en octubre. Cada escalón es una tanda de URLs que Google descubre por enlaces y decide indexar aunque no pueda rastrearlas.
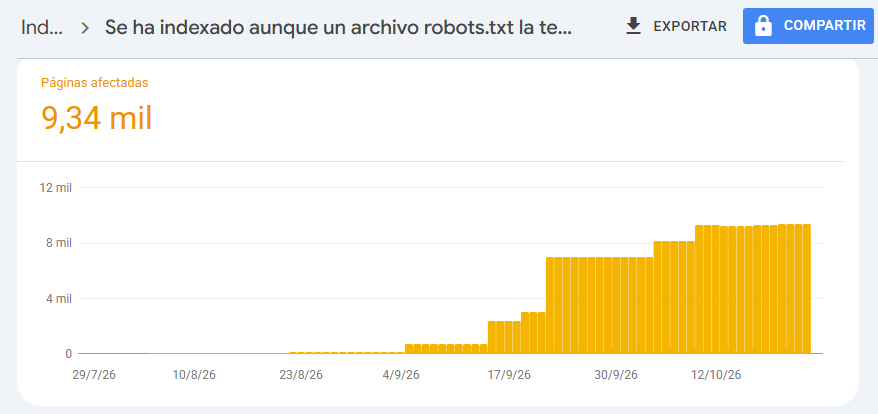
Si inspeccionamos una de esas URLs, la ficha lo deja claro:
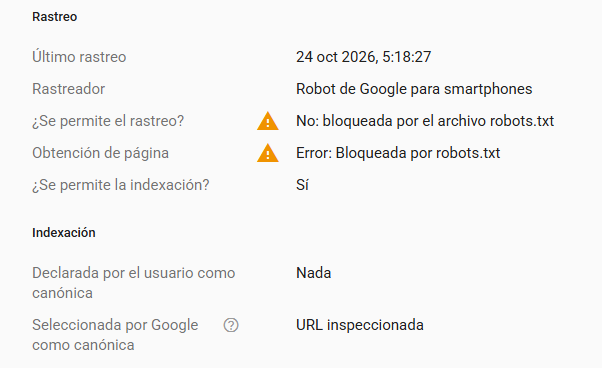
- ¿Se permite el rastreo? No, está bloqueada por el archivo robots.txt. La obtención de la página da error por el mismo motivo.
- ¿Se permite la indexación? Sí. Google no ha podido leer la página, así que no ha encontrado ningún
noindex, y por tanto nada le impide indexarla. - Canónica seleccionada por Google: la propia URL inspeccionada. Como no se rastrea, no puede leer ningún
rel="canonical", y la consolidación de señales que esperabas no se produce.
El resultado es lo peor de los dos mundos: Google gasta recursos en descubrir esas URLs, las indexa sin contenido y tú no puedes controlar cómo se muestran.
Qué pasa en cada escenario
- La página ya estaba indexada y bloqueas el rastreo: Google no podrá actualizarla, así que el título y el resumen que muestra pueden quedar desfasados, y lo seguirá mostrando mientras tenga señales de que existe.
- La página nunca se indexó y la bloqueas: lo normal es que no aparezca, pero si recibe mucho enlazado interno o externo, Google puede indexar la URL sin contenido. Es el caso de la imagen anterior, y Search Console lo avisa con ese estado.
- Añades
noindexa una URL bloqueada: no sirve de nada, porque Google nunca llegará a leerlo. Si quieres desindexarla, primero hay que permitir el rastreo (quitar elDisallow) para que se lea elnoindex, esperar a que desaparezca del índice y solo entonces, si hace falta, volver a bloquear.
Cómo resolverlo
- Decide qué quieres de cada grupo de URLs. Si no quieres que se indexen, la herramienta es
noindex(o una redirección, o un 404/410 si la página ya no debe existir), norobots.txt. - Quita el
Disallowde esas URLs y añadenoindexen la metaetiqueta o en la cabeceraX-Robots-Tag. Es contraintuitivo, pero necesitas que Googlebot entre para leerlo. - Revisa el enlazado interno. Si tu propia web enlaza a miles de URLs que luego bloqueas, estás empujando a Google a descubrirlas. Mejor corregir la causa que taparla con el
robots.txt, como explico en robots.txt como tirita de una arquitectura deficiente. - Supervisa el informe de indexación de Search Console. Cuando Google rastree las URLs y vea el
noindex, pasarán de “Se ha indexado aunque un archivo robots.txt la tenía bloqueada” a “Excluida por la etiqueta noindex” y el número bajará. Tarda semanas, no días. - Si necesitas que desaparezcan ya de los resultados, la herramienta de eliminación de URLs de Search Console las oculta temporalmente, pero no sustituye a lo anterior. Tienes el detalle en cómo eliminar una URL de Google.
- Solo cuando estén fuera del índice, puedes volver a bloquear el rastreo si el objetivo es ahorrar presupuesto de rastreo en secciones enormes. Lo explico en indexación selectiva.
En resumen: robots.txt decide qué se rastrea y noindex decide qué se indexa. Si quieres que algo no aparezca en Google, no lo bloquees, déjalo rastrear con noindex.